AI半導体市場の絶対王者NVIDIAで報じられた、創業以来となるトップの電撃辞任劇。世間やマーケットは「カリスマの引き際」や「スキャンダルの顛末」といった人間ドラマに色めき立っていますが、産業の深層で進んでいる地殻変動は、そんなゴシップよりもはるかに冷徹でスリリングです。
ほぼ同じタイミングで世界を駆け巡った、AI開発企業Anthropicの衝撃的な発表。新規株式公開(IPO)を前にした投資家向け説明会で同社が明かしたのは、従来なら熟練エンジニア数十人が半年から1年を費やしていたAMD製GPU「MI355X」への移植作業を、自社開発の高性能AI「Claude Mythos Preview」自身にコードを書かせ、わずか約3日間で動かしたというデータでした。
王者を玉座から引きずり下ろすために顧客たちが仕掛けたのは、高い「通行税」を払わされ続けた巨大IT企業による、自社の利益を守るための「脱NVIDIA作戦」だったのです。
なぜ「ツルハシ売り」は一番の上客に狙われるのか
ソフトウェア業界の著名な論客ジョエル・スポルスキが提唱した有名な戦略論に、「補完財(ほかんざい)をコモディティ化せよ」という言葉があります。噛み砕いて言えば、「自分たちの商売を成り立たせるために、嫌でも必ずセットで必要になる『部品や環境』は、誰が作っても同じ安い一般品に作り変えてしまえ」という考え方です。
19世紀のゴールドラッシュで最も確実に儲けたのは、金を掘る山師ではなく、彼らにツルハシやジーンズを売りつけた商人だと言われます。現代のAI開発競争において、この「ツルハシ売り」を独占してきたのがNVIDIAです。同社はAIチップ(GPU)というハードウェアの周囲に、専用プログラム基盤「CUDA(クーダ)」という巨大な囲いを築き上げました。NVIDIAのチップを使うならCUDAでプログラムを書くしかなく、一度CUDAで開発してしまえば、次のチップもNVIDIAから買い続けるしかない。この強力な囲い込みによって、NVIDIAは半導体メーカーとしては異次元となる粗利益率70%超、直近では75%という驚異的な儲けを叩き出し続けてきたのです。
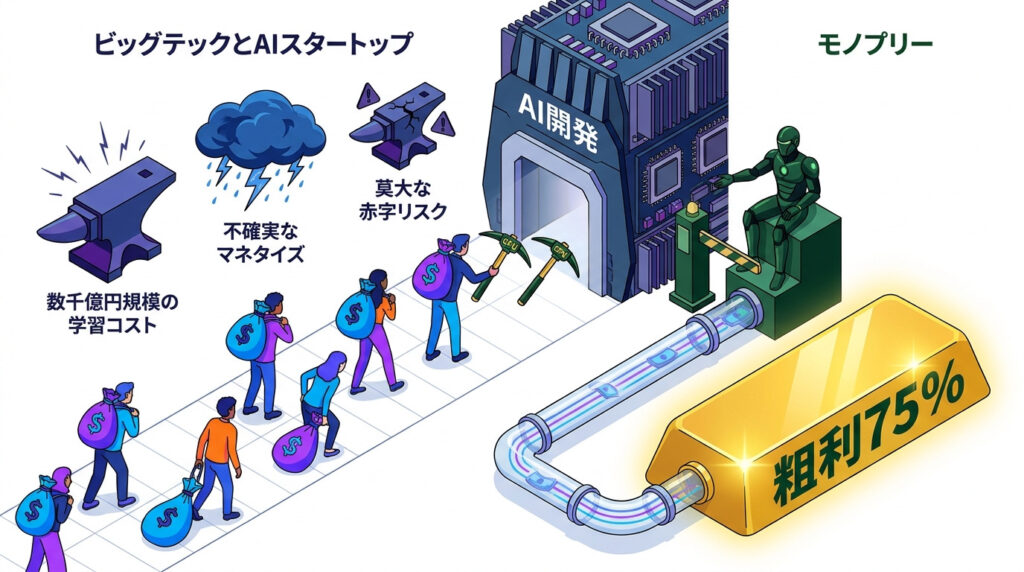
しかし、現代のゴールドラッシュには、19世紀と決定的に異なる点があります。金を掘っている「山師」が、一攫千金を夢見る個人ではなく、Google、Microsoft、Meta、Amazonといった数兆ドル規模の巨大帝国だということです。彼らはいま、AIへの巨額投資が本当に回収できるのかという莫大な赤字リスクを一身に背負わされながら、相棒の部品(チップ)を売るNVIDIAにだけリスクゼロで利益の7割を先取りされるという、いびつな構造に直面しています。
巨大顧客たちにとって、NVIDIAの粗利は自社の利益を削り取る高額な「通行税」以外の何物でもありません。ならば、採るべき手はただ一つです。NVIDIAが独占している「AIを動かすための仕組み」を誰でも使える一般的な技術へと作り変え、AIチップという部品を「どのメーカーから買っても同じように動く、ありふれた工業製品」へと引きずり下ろすことでした。
「CUDAの檻」を、AIが自ら3日間で食い破った日
どれだけ高い通行税に腹を立てていても、巨大テック企業やAI開発会社がこれまで簡単に他社製チップへ乗り換えられなかったのには、明確な技術的理由があります。チップのカタログ性能以上に、プログラム書き換えの「職人芸の壁」が立ちはだかっていたからです。
人間のエンジニアを絶望させていた「翻訳コスト」の正体
AIの膨大な計算を限界まで高速に回すには、チップ内部の物理的な回路に合わせて「カーネル」と呼ばれる細かい制御プログラムを精密に調整しなければなりません。NVIDIAの「CUDA」向けに作り込まれたプログラムは、設計が異なる競合他社(AMDなど)のチップ上ではそのまま動かず、同じ速度を引き出すにはトップクラスの専門エンジニアが数十人規模で張り付き、半年から1年をかけて一から書き直す必要がありました。
数週間単位で勢力図が塗り替わるAI開発競争において、移植のために開発を半年止めることは事業上の死を意味します。顧客は苦々しく思いながらも、高い金を払ってNVIDIAの列に並び続けるしかありませんでした。
「Claude Mythos Preview」が突きつけた3日間移植の衝撃
この膠着状態を力ずくで突き崩したのが、AnthropicがIPOの投資家向け説明会で明かした「AIによる自動移植」です。同社は自社モデル「Claude Mythos Preview」にプログラムの書き換え作業そのものを任せ、AMD製チップ「MI355X」向けの最適化プログラムのほぼ100%を人間の手をほとんど介さずに生成させ、わずか約3日間で実用レベルの性能を立ち上げることに成功したと発表しました。NVIDIAのチップの上で育ったAIが、いまや自らNVIDIAの独占を崩す道具になり始めたのです。
もちろん、この数字には冷静な見方も必要です。これはあくまで上場を前にした同社による自社発表であり、第三者による検証はまだ行われていません。さらに発表資料の小さな脚注には、約3日という期間が「1つのAIモデルについて、質問文を一気に読み込む段階(プロンプト処理)を実用速度で動かせるようになるまで」に限定した数字であることも書かれています。つまり、明日すぐにNVIDIAの牙城が崩れ去るわけではありません。それでも、投資家を前に「もはや一社のチップに命運を握られてはいない」と宣言できたこと、そして高性能AIがチップ間の面倒な翻訳作業を肩代わりし始めた事実そのものが、業界の常識を根底から覆しつつあります。
かつての共犯者も寝返った:巨大テック連合の「二段構え」包囲網
かつて大型コンピュータ市場を支配したIBMの独占は、IntelとMicrosoftが「誰でも安く組み立てられる共通部品」を広げたことで解体されました。そしてそのWindowsの独占を過去のものにしたのも、無料のブラウザやスマホが「裏側の仕組みの違い」を見えなくしたからでした。どれほど強固な独占も、客にとって「別の手段でも同じことができる」状態になった瞬間に終わります。
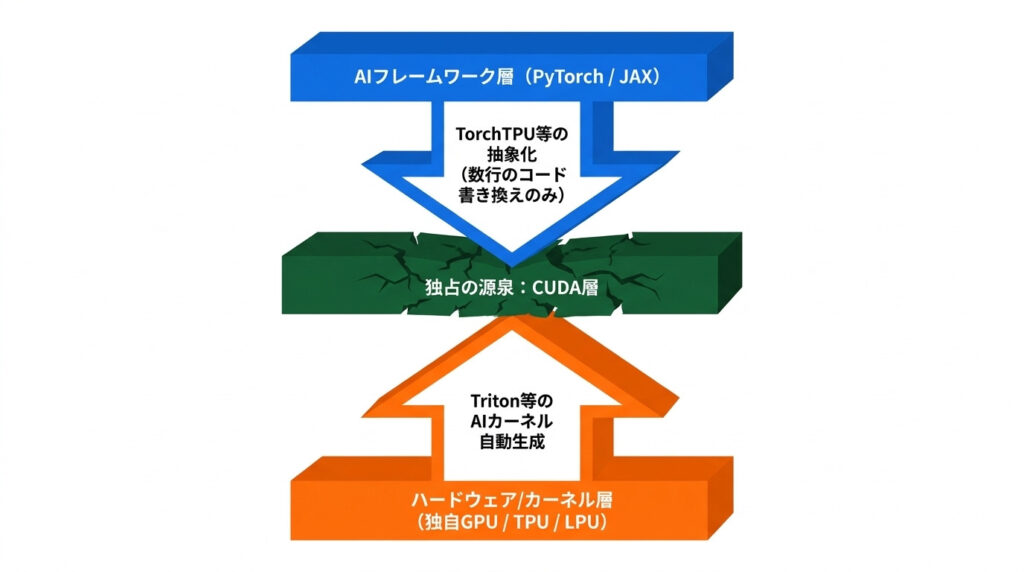
そして現在、かつてはNVIDIAの「上客」であり「共犯者」でもあった巨大企業たちが、ソフトウェアの上側と下側の両方から挟み撃ちにして、CUDAの囲いを無力化する包囲網を敷いています。
第一の矢は、AI開発の世界標準ツール「PyTorch(パイトーチ)」をめぐる裏切り劇です。もともとMetaが開発したPyTorchは、長らくNVIDIAのCUDAを前提に作られてきたため、世界中の開発者をNVIDIAに縛り付ける鎖の役割を果たしていました。ところが今、そのMetaとGoogleが手を組んで「TorchTPU」を無料公開し、Amazon(AWS)も対抗して「TorchNeuron」を送り出しています。
これらはPyTorchに取って代わる別の新しいツールではありません。開発者がこれまで通り使い慣れたPyTorchをそのまま使いながら、裏側で「計算の送り先だけをNVIDIA以外のチップへ切り替える変換アダプタ」です。これを使えば、開発者は新しい作法を覚え直すことなく、プログラム内の送り先指定を「NVIDIA用(cuda)」から「Google用(TPU)」や「Amazon用(neuron)」へ数行書き換えるだけで、標準的なAIモデルのほとんどを他社チップ上で動かせるようになります。
もっとも、通常のプログラムは数行の書き換えで逃がせても、極限まで速度を搾り出すために職人が手書きした「チップ専用の特殊プログラム」や「複数チップ間の高速連絡網」だけは、変換アダプタだけでは動きません。そこで火を噴くのが第二の矢、OpenAIが推す「メーカーを問わず高速プログラムを書ける共通言語(Triton)」や、先述した「AIによる自動書き換え」です。つまり、「普通の処理は変換アダプタで手軽に乗り換えさせ、最後に残る職人芸の領域は共通言語とAIの自動翻訳でこじ開ける」――この二段構えの挟み撃ちによって、ついに顧客たちの脱NVIDIAは現実の選択肢になりました。
ソフト面の逃げ道が整うのと歩調を合わせるように、ハード面の「買い替え規模」も桁違いに膨らんでいます。OpenAIはAMD製チップを6ギガワット(大型の原発6基分の電力をまるごと消費するほどの、途方もない枚数)という規模で確保し、さらに超高速チップを手がける新興企業Cerebrasとも基本契約750メガワット(追加分を含め最大で原発2基分=2ギガワット、総額200億ドル規模)という巨大契約を結びました。一方、自前チップ開発の筆頭であるGoogleは、最大9,600基もの自社チップ(TPU)を1つの巨大な頭脳の塊として直結できる圧倒的な規模を武器に、自社サービスだけでなくAppleやMeta、さらにはクラウド上のライバルであるOracleを経由してまで計算能力の外売りを加速させ、NVIDIAの客を奪い始めています。
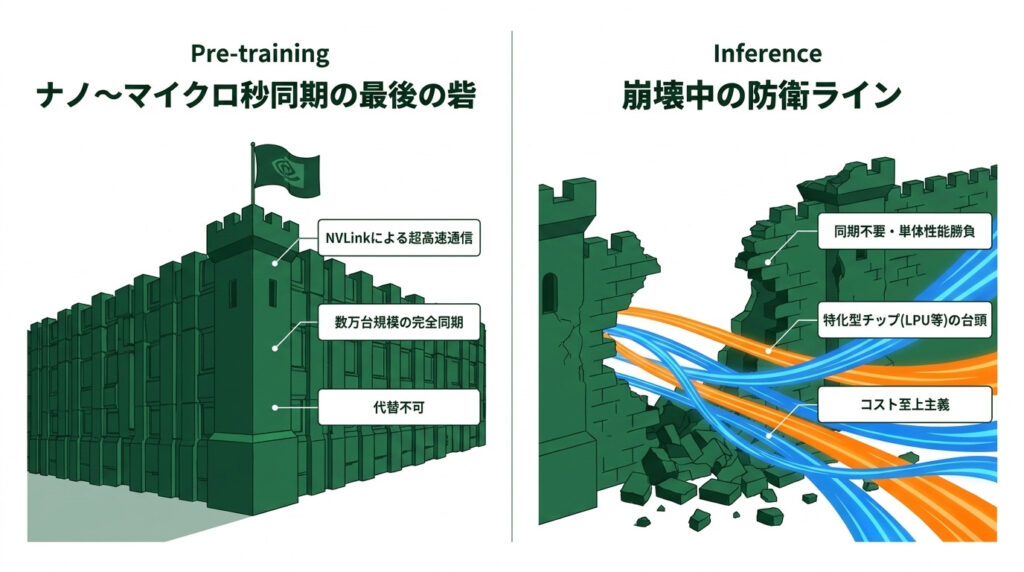
顧客が次々と「自前の道具」を持ち始めた焦りは、王者NVIDIA自身の異例の一手にも表れています。実はNVIDIAのGPUは、大量のデータを抱え込んでAIを賢くする「学習」には強い一方、外付けメモリとのやり取りに時間がかかるため、「AIがユーザーに返事を1文字ずつ超高速で返す(推論)」というスピード勝負では構造的な弱点を抱えていました。そこを突いて急浮上したのが、計算回路のすぐ隣に超高速メモリ(SRAM)を直付けして返答スピードに特化した「Groq(グロック)」などの新興チップ勢です。
このままでは今後の主戦場である「AIを動かすスピード競争」で主導権を奪われかねない――そう危機感を抱いたNVIDIAは、かつてGoogleで初代TPUを設計したジョナサン・ロス氏率いるそのGroqに対し、約200億ドル(約3兆円)とも報じられる巨額契約に踏み切りました。独占禁止法の厳しい審査をかわすため「会社丸ごとの買収」は避けて「特許ライセンス契約」という形を取りつつ、実態はGroqの創業者と従業員の約9割をごっそり引き抜く事実上の丸呑み。さらにその技術を使い、従来のGPUとは別物の推論専用マシン「NVIDIA Groq 3 LPX」の量産まで始めました。これまで「GPUとCUDAさえあれば無敵」と胸を張ってきた王者が、3兆円を投じてライバルの別方式チップを取り込まなければ守れないほど、足元の土俵は激しく揺らいでいるのです。
| 戦場 | 従来のNVIDIA支配構造 | 連合軍の解体アプローチ(現在地) |
|---|---|---|
| 開発の入り口(標準ツール) | CUDAへの完全ロックイン。定番ツールPyTorchもNVIDIA前提で設計 | TorchTPU / TorchNeuron(変換アダプタ)の登場により、数行の送り先変更だけで他社チップへ逃走可能 |
| 高速化の裏側(職人領域) | チップ密着のチューニングは熟練エンジニア数十人×半年〜1年の手作業が必須 | Triton(共通言語)やClaude Mythosの自動書き換えにより、一部処理の移植壁を数日単位へ圧縮 |
| 推論(応答スピード競争) | 圧倒的なエコシステムで一強を維持 | 防衛ライン崩壊中。Google TPU・AMD(6GW)・Cerebras(750MW〜)へ分散。王者も約3兆円でGroq技術と開発陣を事実上丸呑みし防戦 |
| 事前学習(巨大AIの育成) | 数万基のGPUをナノ〜マイクロ秒単位で同期させる高速配線と連絡網の総合力 | 依然として堅牢。超高速な連携制御と750万人を超えるCUDA開発者網が最後の防波堤 |
もっとも、冷静に足元を見れば、NVIDIAの帝国が今日明日で崩れ去るわけではありません。数万基のチップをナノ〜マイクロ秒単位(100万分の1秒以下)という極限のタイミングの狂いもなく連携させ、巨大AIを一から育て上げる「事前学習」の領域では、チップ同士を直結する配線(NVLink・InfiniBand)から全体の交通整理(NCCL)まで含めたNVIDIAの総合力が依然として圧倒的です。世界中に広がる750万人超のCUDA開発者網という巨大な地盤も、一朝一夕には揺らぎません。それでも、「絶対に越えられない」と信じられていた堀の水位が、顧客の執念とAI自身の進化によって音を立てて下がり始めた意味は決定的です。
カリスマの退場より恐ろしい「もう1社独占には払わない」という商売の現実
創業者の電撃的な辞任というニュースに、世間は「偉大なリーダーの失脚劇」や「次の社長は誰か」といった人間模様の物語を求めたがります。ですが、テクノロジー業界の地図を冷酷に塗り替えているのは、個人のスキャンダルや交代劇ではありません。そこに働いているのは、「1社が儲けの7割を独り占めし続ける商売は、絶対に長続きしない」というビジネスの現実です。
仮にカリスマ経営者が不祥事ひとつ起こさず、永遠に革ジャンを着てステージに立ち続けていたとしても、この包囲網は1ミリも避けられませんでした。なぜなら、自分たちが巨額の赤字リスクを背負う一方で部品屋にだけ大儲けされ続ければ、資本力のある顧客が「自前で代わりのチップを設計し(Google TPU・AMD)」「誰でも乗り換えられる無料の変換アダプタを配り歩き(TorchTPU)」「面倒なプログラム書き換えまでAIに丸投げする」と動くのは、商売として避けられない必然だからです。
ゴールドラッシュのツルハシ売りが本当に恐れるべきなのは、金が掘れなくなる日ではありません。上客たちが裏で自分用のツルハシを鋳造し始め、どんなツルハシでも同じように掘れる工夫を無料で配り始めた日です。王者の交代劇という騒がしいニュースの向こう側で、AIインフラの利益を奪い返す戦いは、すでに次の段階へと動き出しています。